AI 视频分镜提示词:用时间轴写清 15 秒短片的节奏
学习如何将短片拆分成时间段,以用于 AI 视频生成。本指南侧重于为特定时间块分配叙事任务,优化提示词以获得清晰度和影响力。
 Genvizu Team约 3 分钟读完

当短片包含多个场景时,AI 视频分镜提示词 应把故事拆成时间段,并让每一段只完成一个叙事任务。与其写一大段“宏大、激烈、电影感”的描述,不如明确 0 至 3 秒看什么、3 至 6 秒发生什么,以及最后一镜如何收束。
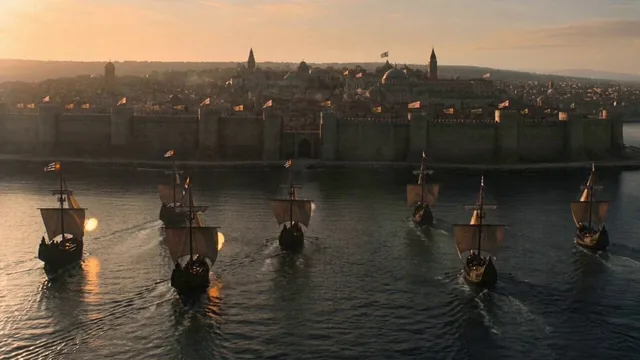
这条 15 秒历史场景 gallery 视频 将内容切成五个 3 秒段落:舰队抵达、城墙受击、突破防线、商人装载物品、舰队离开。无论具体历史叙事是否还需要校对,这种时间轴结构都值得学习,因为每一段都有明确动作和画面目标。
先用一句话写完整故事
分镜之前,先写一句“开始、变化、结果”都存在的故事摘要:
一支舰队在黎明抵达城市,防线被突破,最后带着战利品离开燃烧的港口。
如果一句话里已经出现五六个转折,短片通常装不下。15 秒内容更适合一个事件、一次变化和一个结尾,而不是完整讲述一段复杂历史。
按叙事任务分配时间
一个简单的 15 秒节奏可以是:
时间任务常用画面0-3 秒建立地点与冲突全景、环境、主要双方3-6 秒第一次动作接近、启动、碰撞或发现6-9 秒变化升级突破、追逐、转折或揭示9-12 秒结果出现近景反应、关键物件或代价12-15 秒收束与记忆点最终姿态、远景、产品或 CTA 画面
每段只回答三个问题:镜头看哪里、主体做什么、这一段结束时发生了什么。暂时不要把颜色、材质和特效写满,先保证故事能够被读懂。
每个分镜使用相同字段
统一格式可以避免漏掉关键信息:
[00:00-00:03]
SHOT: wide establishing shot
SUBJECT: fleet approaches the city walls at dawn
ACTION: ships advance while defensive banners move in the wind
CAMERA: slow aerial push forward
TRANSITION: smoke fills frame and masks the cut
下一段继续使用 SHOT、SUBJECT、ACTION、CAMERA 和 TRANSITION。结构一致后,更容易发现某一段是否同时塞进过多动作,或者两段之间缺少连接。
用景别变化建立节奏
连续五个大全景会让事件缺乏情绪,连续五个特写又会失去空间关系。可以使用“全景建立环境、中景展示动作、近景确认结果”的顺序。
运镜也应跟随段落功能:建立镜头可以缓慢推进,动作段落可以跟拍,结果段落可以固定或缓慢拉远。Runway 的 AI Video Prompting Guide 提醒,在单个提示中加入多个相互竞争的摄影机方向,可能产生混乱结果。分镜化的价值之一,就是把不同运镜分配到不同镜头,而不是挤在同一瞬间。
转场必须有画面依据
“cinematic transition”不说明怎样转场。更实用的方式是让画面中的元素遮住镜头,例如烟雾、快速经过的人物、甩动的衣服、强光或运动模糊。下一镜从相似颜色、方向或形状接上,连贯性会更好。
常见写法包括:
-
smoke fills the frame, revealing the next location
-
whip pan right into the next shot
-
foreground object briefly occludes the lens
-
match cut from a circular wheel to a setting sun
如果模型或当前生成模式不擅长多镜头,可以把每段分别生成,再在剪辑软件中组合。分镜仍然有用,因为它让每段素材的起点、终点和运动方向提前对齐。
把事实准确性和视觉生成分开检查
历史、科学、产品功能或新闻类视频不能只追求画面冲击。生成前应单独核对人物、地点、时间、服装、标志和因果关系;不要因为 gallery 示例能生成,就把其叙事当成事实来源。
完成提示词后进行两轮检查:第一轮只看内容是否准确、时间是否装得下;第二轮再看镜头、风格、光线和声音。这样可以避免用大量视觉细节掩盖故事错误。
生成你的 AI 视频分镜提示词
把一句话故事、时长和目标画幅输入 Genvizu AI 视频提示词生成器,先得到可执行的时间轴,再逐镜调整动作、运镜与转场。